Tener 256 GB de VRAM para IA local cuesta desde unos 5.000 euros por un servidor usado hasta más de 54.000 por una torre de gráficas nuevas. Repasamos todas las formas de llegar, cuánta de esa memoria le llega de verdad al modelo y por qué el precio por giga engaña.
Partimos de este vídeo de Jorge Marfil sobre cómo conseguir 256 GB de VRAM para IA local, publicado el 8 de noviembre de 2026. Los precios son de Estados Unidos, sin impuestos, de finales de octubre y principios de noviembre, y los hemos pasado a euros al cambio del 10 de noviembre (1 euro, 1,12 dólares). Con la escasez de memoria cambian casi cada semana, y en España hay que sumarles el IVA. Las cifras de usuarios de foros son experiencias sueltas, no medias.
1 Por qué todo el mundo busca 256 GB
256 GB es donde empiezan a caber los buenos modelos abiertos medianos sin recortarlos tanto que pierdan calidad. Para entender por qué, hacen falta tres ideas:
Cuantización
Guardar el modelo con menos precisión, 6 o 4 bits por valor, para que ocupe menos a cambio de algo de calidad.
Mezcla de expertos
El modelo está partido en bloques y en cada paso solo trabajan unos pocos, pero todos tienen que estar en memoria.
Caché KV
Donde vive la conversación. Crece con cada mensaje y se come memoria que dejas de tener para el modelo.
La mezcla de expertos es la clave. Qwen 3 235B tiene 235.000 millones de parámetros, pero solo usa 22.000 millones en cada paso, así que va bastante más rápido que un modelo denso de su tamaño. La trampa es que los expertos que no trabajan en ese momento tienen que seguir cargados, porque el siguiente token puede pedir otros. Te da velocidad y te sigue pidiendo toda la memoria. Por eso lo que la gente sale a comprar para la IA local es memoria.
| Modelo | Precisión | Memoria que ocupa |
|---|---|---|
| Qwen 3 235B | 6 bits | Unos 193 GB |
| MiniMax M2.5 | 6 bits | Unos 188 GB |
| GLM 4.7 | 4 bits | De 192 a 216 GB |
| Qwen 3.5 397B | 4 bits | De 224 GB (MLX) a 245 GB (GGUF) |
El último ya va justísimo. GGUF es el formato con el que trabaja llama.cpp, y MLX, la herramienta de Apple para correr modelos en el Mac.
2 Los tres relojes de una caja para IA local
Jorge Marfil compara comprar una caja de 256 GB con comprar un coche familiar: la etiqueta es solo una parte de lo que pagas, y el resto te lo vas encontrando con los años. Lo explica con tres relojes que empiezan a correr el día de la compra:
El primero es el que menos se ve en un anuncio y el que más pesa. A estas máquinas suele retirarlas el software que deja de llegar, mucho antes de que se les rompa nada: el chip sigue encendiendo, pero las versiones nuevas de las herramientas ya no se compilan para él.
3 Cuánta memoria le llega de verdad al modelo
Casi ninguna caja de IA local le da al modelo los 256 GB enteros. Es como el maletero del folleto, medido con el hueco de la rueda de repuesto dentro.
En el Mac, macOS deja de serie que la GPU use más o menos tres cuartas partes de la memoria, así que un Mac Studio de 256 GB empieza dándote unos 192. Esa regla del 75 % la repite todo el mundo, aunque Apple solo la cumplió en una de las dos cifras que dio para los M1 y en las versiones recientes de macOS parece más generosa. Se cambia con una línea en el terminal, la que documenta el proyecto MLX de Apple:
sudo sysctl iogpu.wired_limit_mb=237568
Ese número son megas: 237.568 MB son 232 GB, lo que deja 24 al sistema. Con este ajuste se llega a unos 230 o 248 GB, siempre por debajo de la memoria total.
El cambio se borra en cada reinicio. Mételo en un script que se ejecute al iniciar sesión, o el primer reinicio te devolverá a los 192 GB y pasarás una tarde sin entender por qué el modelo que ayer cargaba hoy no carga.
En los mini PC de AMD el techo está en otro sitio. En Windows, la gráfica de un equipo de 128 GB se queda en 96 por caja. En Linux se puede subir: AMD habla de 120 GB por caja con un parámetro del kernel, pero Jeff Geerling, probando un clúster de placas Framework, vio que unos 108 era lo máximo estable y que a 110 empezaban los cuelgues.
Y compres lo que compres, el sistema y la conversación se llevan su parte. En la práctica, planifica con unos 220 a 235 GB para el modelo. Cualquier comparativa que le reparta los 256 enteros te vende el maletero con la rueda dentro.
4 Las seis formas de llegar a 256 GB para IA local
Este es el precio de cada camino hacia la IA local con 256 GB. Ojo, porque la barra más corta no es la más barata a la larga, y eso lo vemos en la sección 7.
Mac Studio con M5 Ultra: la opción obvia
Llegó en septiembre con 1,2 TB por segundo de ancho de banda, que es lo que manda en la velocidad al escribir: cada token nuevo obliga a leer otra vez los pesos activos. La versión de 256 GB cuesta 8.460 euros si Apple deja elegirla con el chip de 64 núcleos de GPU, o 9.620 si va ligada al de 80. Las fuentes no se ponen de acuerdo, así que mira el configurador antes de pedirlo, porque te juegas unos 1.160 euros. Las entregas iban a finales de enero de 2027.
En las pruebas de MacStories escribía a 108 tokens por segundo frente a 70 del M3 Ultra con el mismo modelo, gastaba unos 300 W y apenas se oía. Su pega está en otro sitio: escribe rápido, pero lee despacio. Con un prompt de 6.000 tokens leía unos 1.700 tokens por segundo, frente a unos 3.000 de una RTX 5090.
Prefill y decode: leer el prompt entero antes de contestar se llama prefill, y generar la respuesta, decode. Un equipo puede ser rápido en uno y lento en el otro. Si trabajas con agentes que releen mucho código, el prefill es lo que más vas a notar.
Mac Studio con M3 Ultra de segunda mano
Apple dejó de venderlo con 256 GB en mayo, y desde entonces solo se consigue usado. Del 24 de octubre al 2 de noviembre se vendieron en Swappa tres unidades de 256 GB por entre 6.880 y 7.060 euros, cuando nuevo costaba unos 6.680. Un ordenador de año y medio vendiéndose por lo mismo que costó es rarísimo. Es bastante más lento que el M5 Ultra, pero es el que mejor ha demostrado que guarda su precio.
Dos DGX Spark de Nvidia unidas por un cable
Cada Spark tiene 128 GB, así que hacen falta dos. Salió a 3.560 euros y en octubre ya costaba 6.190 por la escasez de memoria: dos cajas son 12.390 euros más el cable. Escribiendo van casi empatadas con el M5 Ultra, pero en la comparación de MindStudio leían un código de 32.000 tokens en unos 17 segundos, frente a entre 44 y 50 del Mac. Tienen el soporte de software más largo de este repaso, porque CUDA es donde aterriza primero cualquier herramienta nueva. Lo que valdrán usadas, nadie lo sabe todavía.
Dos mini PC de AMD con Strix Halo
La forma más barata de llegar con equipos nuevos, aunque han subido muchísimo: el Framework Desktop de 128 GB salió a 1.780 euros y hoy aparece a 3.070, agotado. Dos son 6.150. Dejan entre 210 y 240 GB útiles y gastan unos 150 W por caja a plena carga. Su ancho de banda es modesto, unos 256 GB por segundo, y un clúster de la comunidad movía un modelo de 230.000 millones de parámetros a unos 21 tokens por segundo. Unirlas da guerra, porque el USB4 se queda en unos 10 GB por segundo, y el prefill es lento de verdad. Antes de comprar dos, mira una sola caja con Gorgon Halo y 192 GB, que parte de 6.060 euros.
Una torre llena de gráficas nuevas
Ocho RTX 5090 de 32 GB salen de 34.800 a más de 54.400 euros según de dónde saques los precios, y gastan unos 4.600 vatios solo en gráficas. La gama profesional sorprende: la RTX PRO 5000 de 72 GB sale a unos 111 euros por giga, más barata por giga que la 5090, y gasta 300 W. Cuatro dan 288 GB por entre 32.100 y 35.600 euros. Con cuatro RTX PRO 6000 se han visto los números más rápidos: más de 900 tokens por segundo sirviendo a 32 usuarios a la vez.
Compra dos, cuatro u ocho tarjetas, nunca tres. vLLM reparte cada capa del modelo entre todas las tarjetas, y si el número no divide bien el modelo te manda a otro reparto que acelera mucho menos.
Los servidores viejos de V100 y MI50
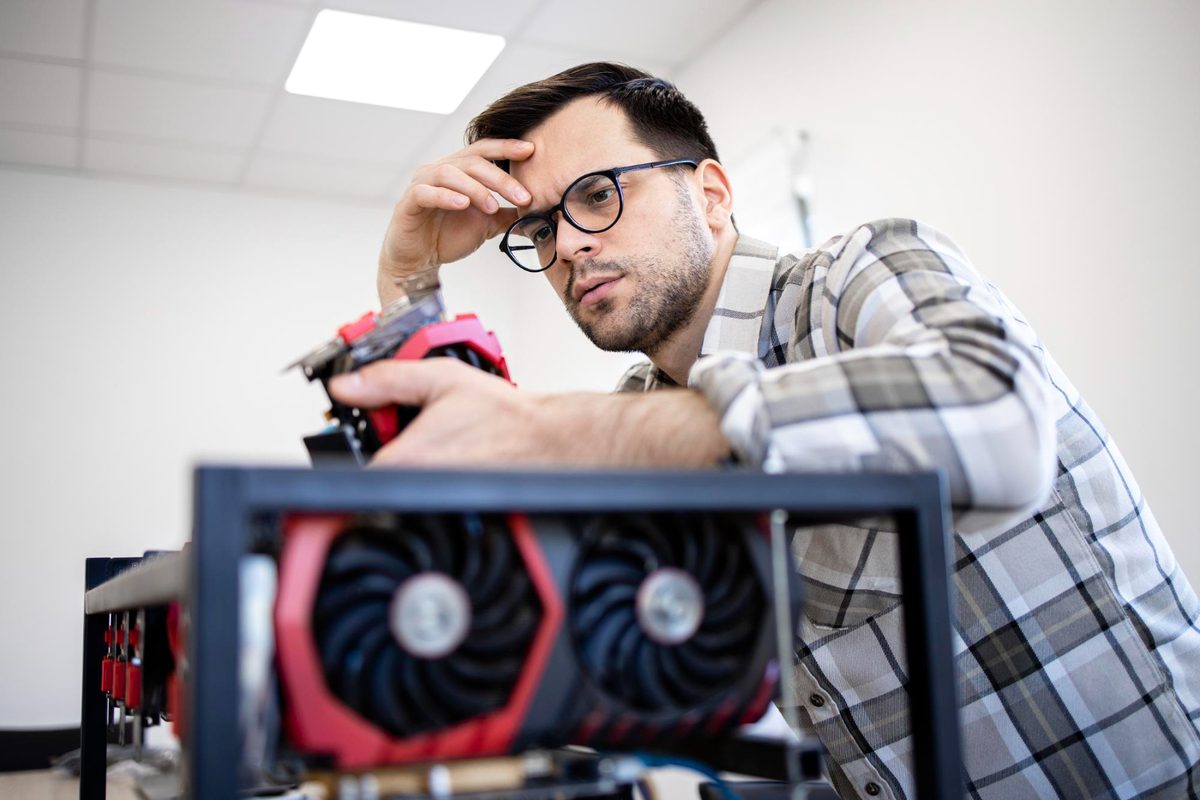
Sobre el papel, el chollo del año para la IA local. Un servidor de rack con ocho V100 de 32 GB lleva memoria HBM, la rapidísima que va pegada al chip, y tarjetas unidas por NVLink a 300 GB por segundo. El más barato que encontró Jorge Marfil pedía 5.010 euros, menos de 20 euros por giga, cuando las tarjetas nuevas salen entre 111 y 214 en las que él miró. Y funcionan: los vendedores los anuncian para modelos de la clase de DeepSeek, y el modelo carga.
La contrapartida: piden corriente de 240 V, mueven entre 2,5 y 3,2 kW a tope y suenan como un secador atascado. La versión de AMD es la MI50, una tarjeta de 32 GB que se ha llegado a encontrar por unos cientos de euros. Lo que queda por saber es cuánto tiempo seguirán cargando lo que a ti te interesa.
5 La fecha de caducidad del servidor viejo
Aquí hay que separar lo que aguanta de lo que se ha exagerado.
Lo que es verdad
- CUDA 13 dejó de compilar para Volta, la arquitectura de la V100
- vLLM 0.20 pide una capacidad de cómputo de 7.5 y la V100 tiene 7.0
- LM Studio ya no las reconoce como GPU CUDA
- ROCm 7 marca la MI50 como no soportada
Lo que se ha exagerado
- llama.cpp sigue publicando versiones con CUDA 12
- Ollama la lista como soportada con el driver 550 o posterior
- Los drivers R580 de Nvidia la soportan hasta junio de 2028
- La comunidad mantiene versiones parcheadas
Las notas de CUDA 13.0, de agosto de 2025, lo dicen claro: se elimina la compilación para Maxwell, Pascal y Volta, y con la serie 12 se puede seguir compilando para ellas. Así que la V100 no se apaga hoy. Lo que pasa es que cada herramienta nueva se escribe ya para otros chips y tú vas a depender de versiones antiguas y de gente que parchea por amor al arte. Es el taller de barrio que te mantiene el coche viejo andando. Cuánto le queda, la respuesta honrada es que nadie lo sabe. Si lo compras para IA local, cuenta con eso desde el primer día.
6 El día que el modelo creció
Hasta septiembre, DeepSeek V4 Flash era casi el modelo perfecto para 256 GB: en 4 bits sus ficheros sumaban unos 160 GB y quedaba sitio de sobra para conversaciones largas. El 10 de septiembre, DeepSeek anunció V4.1 Flash y retiró el anterior de su API. El nuevo es mucho más grande: 552.000 millones de parámetros en la parte principal más una memoria aparte, que llaman Engram, de otros 196.000 millones.
El Engram funciona como una enciclopedia enorme de la que el modelo solo consulta unas pocas entradas cada vez, así que puede quedarse en el disco. Aun así, la versión de 2 bits necesita unos 200 GB en memoria, y la de 3 bits más pequeña, 233,5 GB, que se come casi todo lo que planificábamos y no deja sitio para la conversación. Y va más lento: un probador sacó unos 21 tokens por segundo en un M5 Ultra, donde el modelo anterior iba a unos 40.
Ninguna caja ha cambiado y todas siguen teniendo sus 256 GB, pero el mejor DeepSeek que puedes correr cómodo en este escalón vuelve a ser el anterior. Ese es el reloj del modelo, y corre para todas las cajas de IA local por igual. Si te interesa más usarlo por API, lo contamos en DeepSeek Harness, su API de pago y los modelos V4.
7 Cuánto cuesta cada año útil, y si compensa alquilar
Con todo esto ya se puede echar la cuenta que importa. Jorge Marfil la hace con dos supuestos suyos, discutibles: el servidor viejo da dos años buenos antes de que el software se le vaya del todo, y el Mac da cinco. La luz, con el precio medio residencial de Estados Unidos en agosto de 2026, unos 16,2 céntimos de euro el kWh, y ocho horas al día todo el año.
- Servidor de 5.010 euros: 2.505 por año útil, más 1.512 de luz a 3,2 kW. Total, 4.017 al año.
- Mac Studio de 8.460 euros: 1.692 por año útil, más 142 de luz a 300 W. Total, 1.834 al año.
- Si vendes el Mac por 1.800 euros al cabo de cinco años, una cifra inventada para ver el efecto, baja a unos 1.474.
Los gigas baratos dejan de serlo en cuanto los divides entre años, igual que el coche de segunda mano que te sale regalado y luego gasta como un camión.
Haz la cuenta con tu luz: kilovatios del equipo por horas al día por 365 por el precio del kWh de tu factura. En un servidor viejo, la luz de dos años puede costar más que la propia máquina.
Alquilar o pagar por tokens
Antes de comprar nada para IA local, mira si compensa comprar. Alquilar unos 256 GB de GPU en la nube cuesta de 5,80 a 9,80 euros la hora, y con tres RTX PRO 6000 se encuentran entre 4,95 y 6,65. Los 8.460 euros del Mac dan para entre 1.270 y 1.710 horas de alquiler, de cinco a siete meses a ocho horas al día.
Por tokens, la cuenta es todavía más dura. La API de DeepSeek cobra V4.1 Flash a 0,53 euros por millón de tokens de salida fuera de hora punta. El Mac, a tope día y noche con ese modelo, sale a unos 4,90 euros por millón contando la luz de tres años. Para una persona, la API es entre 5 y 9 veces más barata y encima corre el modelo entero, no una versión de 2 bits. La IA local solo gana en coste cuando el equipo está ocupado: cuatro RTX PRO 6000 sirviendo a muchos usuarios bajan a menos de un euro por millón.
8 Para quién cambia el veredicto
Todo lo anterior va de dinero, y hay casos en los que el veredicto se da la vuelta:
Datos que no pueden salir
Si tu código, los ficheros de tus clientes o los historiales de tus pacientes no pueden salir de la oficina, la nube deja de ser una opción, cueste lo que cueste.
Un modelo que no cambie
Un usuario descubrió en sus registros que su proveedor había cambiado los pesos del modelo sin avisar. Con los pesos en tu disco, eso no pasa.
Algo concreto de CUDA
Un script de ajuste fino o agentes que releen prompts enormes todo el día. Ahí las Spark sacan ventaja.
Garaje y luz barata
Si pelearte con el servidor es la mitad de la gracia, las cuentas por año útil te importan bastante menos.
El primer caso es el que más vemos en empresas. Si tratas datos personales de clientes o pacientes, mandarlos a una API es una transferencia que tienes que poder justificar ante el RGPD, y a veces la respuesta es no. Para ese trabajo, la IA local es lo que cuesta poder hacerlo, y no hace falta llegar a 256 GB: hay herramientas que ya corren en un equipo normal, como estas alternativas gratis a NotebookLM, Perplexity y Granola que funcionan en local. Si lo que necesitas es poner en orden qué datos tratas y con quién, eso es nuestra adaptación al RGPD.
En el otro extremo, si solo charlas con un modelo unas horas a la semana, paga por tokens: ninguna de estas cajas te va a salir a cuenta.
9 Cómo elegir y qué comprobar antes de pagar
Así lo resume Jorge Marfil, caja por caja:
- La vida más larga con menos líos: Mac Studio M5 Ultra de 256 GB, con el límite de memoria subido el primer día y el script para que sobreviva a los reinicios.
- El Mac por menos dinero: M3 Ultra de 256 GB usado, por unos 6.860 euros. Lee los prompts todavía más despacio, pero guarda su precio.
- Dos DGX Spark: solo si puedes señalar la herramienta exacta que necesita CUDA, o si vives con agentes de programación que releen prompts enormes.
- Dos mini PC de AMD: si quieres equipo nuevo con poco dinero, te manejas en Linux y te valen los modelos medianos a unos 20 tokens por segundo. Antes, mira la caja única de 192 GB.
- Gráficas RTX PRO: si das servicio a un equipo. Cuatro, nunca tres.
- Servidor viejo: solo con garaje, luz barata y como proyecto de dos años, nunca como inversión a cinco.
La regla para llevarte: el precio de una caja de IA local se divide entre los años que te va a servir antes que entre sus gigas. Y una tarea para hoy mismo, si ya tienes equipo: mira cuál es la versión más nueva de CUDA o de ROCm que admite tu tarjeta y si tus herramientas se siguen compilando para ella.
Si quieres empezar con lo que ya tienes, la guía de ComfyUI explica qué equipo hace falta para generar imágenes en local. Y si lo tuyo es programar con modelos, mira cómo programar con agentes de IA sin perder el control.
¿Quieres usar IA sin que tus datos salgan de la empresa?
Te ayudamos a decidir qué puede ir a una API y qué conviene dejar en local, y a dejarlo por escrito para cumplir el RGPD.
Preguntas frecuentes sobre la VRAM para IA local
¿Cuánta VRAM necesito para IA local?
Depende del modelo. Los modelos pequeños corren en una gráfica de 16 o 24 GB, pero los buenos modelos abiertos medianos piden entre 190 y 245 GB en 4 o 6 bits. Con 256 GB, planifica unos 220 a 235 para el modelo, porque el sistema y la conversación se llevan su parte.
¿Sirve un Mac para IA local?
Sí. Un Mac Studio comparte una sola memoria entre el procesador y la GPU, escribe rápido, gasta poco y dura años con soporte. Su pega es que lee despacio los prompts largos, y de serie solo deja a la GPU unas tres cuartas partes de la memoria, algo que se cambia con un comando.
¿Compensa más pagar una API que comprar un equipo?
Para una sola persona, casi siempre: la API de DeepSeek sale entre 5 y 9 veces más barata que un Mac Studio de 256 GB funcionando sin parar. Comprar compensa si los datos no pueden salir de tu empresa, si necesitas que el modelo no cambie o si el equipo va a estar ocupado casi todo el día.